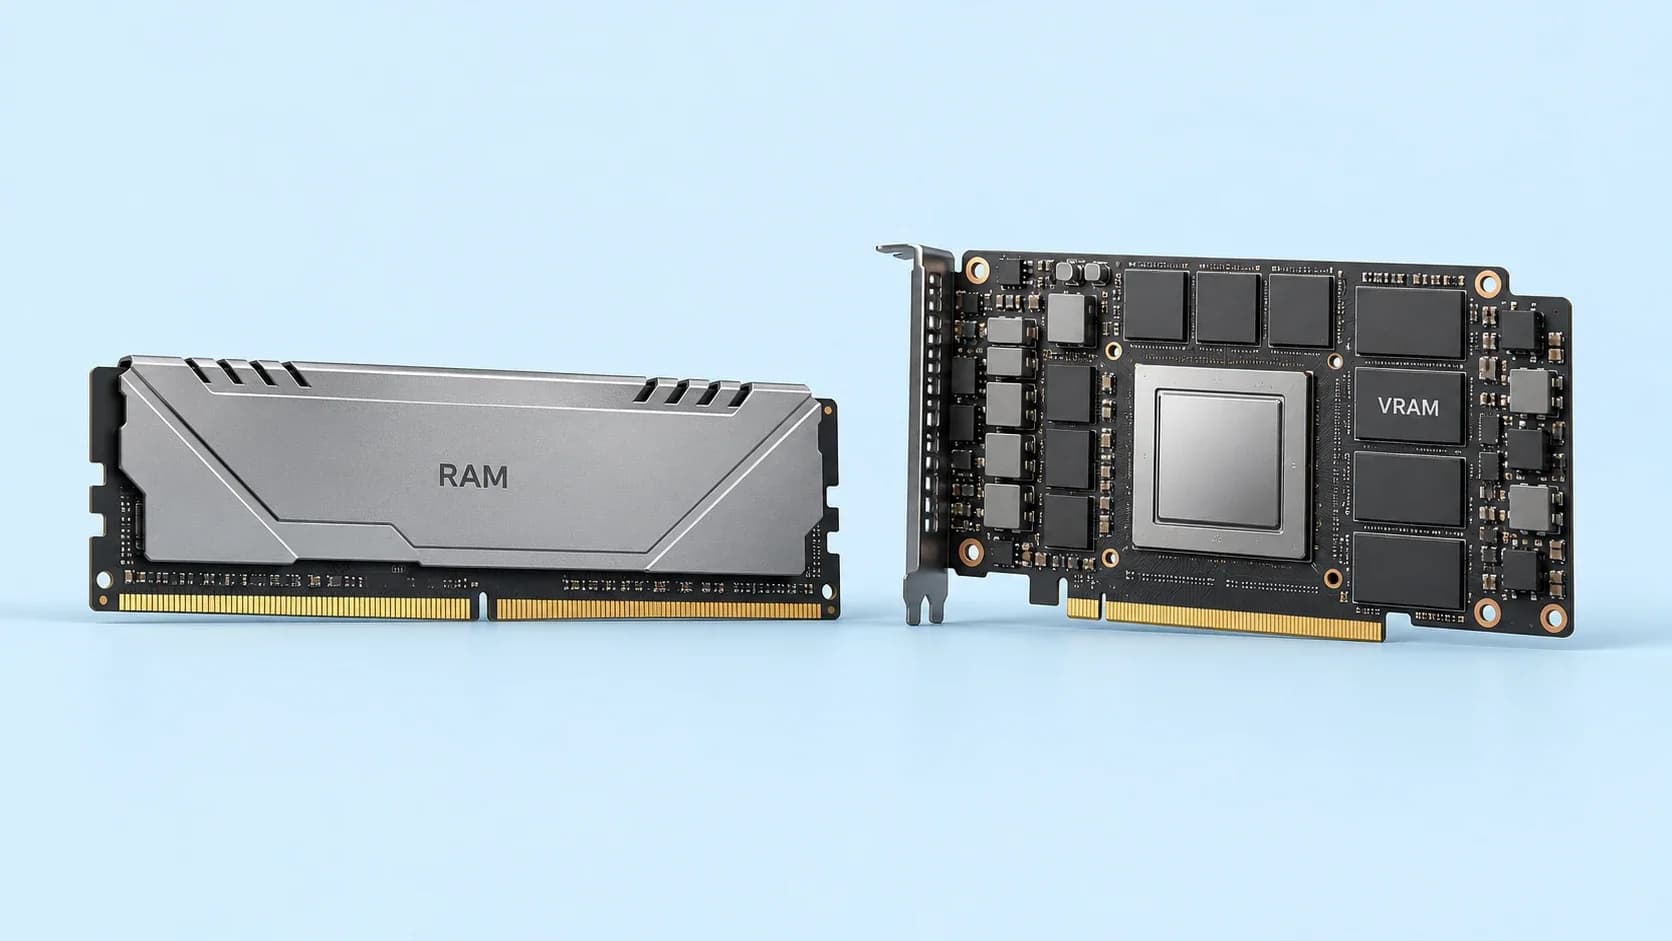
برای اجرای هوش مصنوعی روی کامپیوتر، مقدار RAM و VRAM به مدل، دقت وزنها، طول Context و نرمافزار بستگی دارد. ابتدا مشخص کنید قرار است مدل زبانی اجرا کنید، تصویر بسازید یا فاینتیون انجام دهید؛ نیاز حافظه این کارها یکسان نیست. این راهنما روش برآورد حافظه و تشخیص اولویت ارتقا را توضیح میدهد تا کانفیگ را بر اساس پروژه انتخاب کنید.
حداقل سختافزار لازم برای اجرای مدلهای هوش مصنوعی
برای اجرای مدلهای هوش مصنوعی روی کامپیوتر شخصی، مقدار RAM و VRAM موردنیاز به اندازه مدل، روش اجرا و طول Context بستگی دارد. مدلهای کوچک را میتوان روی سیستمهای معمولی اجرا کرد. اما مدلهای بزرگتر به حافظه بیشتری نیاز دارند. استفاده از نسخههای کوانتیزهشده نیز میتواند مصرف حافظه را کاهش دهد. در این بخش، تمرکز ما بر اجرای محلی مدلهای زبانی بزرگ (LLM) است؛ یعنی اجرای مدل روی کامپیوتر شخصی، بدون اینکه لازم باشد هر درخواست را به یک سرویس ابری بفرستید. اعداد جدولهای زیر برای برآورد اولیه مناسباند. مقدار واقعی حافظه موردنیاز به مدل، نرمافزار و تنظیمات اجرا بستگی دارد.
حداقل RAM برای اجرای مدلهای هوش مصنوعی چقدر است؟
RAM باید برای سیستمعامل، برنامهها و بخشهایی از مدل که در حافظه اصلی قرار میگیرند کافی باشد. نام گروه 7B یا 32B بهتنهایی حداقل رم را تعیین نمیکند. فایل دقیق مدل، روش بارگذاری و برنامههای همزمان را مشخص کنید و مصرف واقعی را اندازه بگیرید.
- اجرای CPU: حافظه وزنها و دادههای اجرایی در رم سیستم جا میگیرند؛ حافظه آزاد را معیار قرار دهید.
- اجرای ترکیبی: سهم مدل در RAM و GPU به ابزار و تنظیمات تخصیص وابسته است.
- اجرای GPU: رم سیستم همچنان برای سیستمعامل، آمادهسازی داده و بارگذاری برنامه لازم است.
- فاینتیون: نیاز حافظه را با یک مرحله آموزش واقعی بسنجید؛ تست استنتاج کافی نیست.
اگر سیستم فعلی دارید، قبل از خرید ماژول جدید، مصرف حافظه را در یک اجرای معمول و یک اجرای سنگین ثبت کنید. رسیدن مصرف رم به سقف یا استفاده زیاد از حافظه مجازی نشانهای برای بررسی است. ظرفیت پیشنهادی عمومی جای اندازهگیری همان مدل را نمیگیرد.
برای اجرای مدلهای زبانی به چند گیگابایت VRAM نیاز داریم؟
VRAM باید علاوه بر وزنهای قرارگرفته روی GPU، فضای دادههای میانی، کش و سربار موتور اجرا را پوشش دهد. بهجای انتخاب کارت تنها با نام مدل زبانی، تنظیمات اجرا و حافظه آزاد کارت را بررسی کنید.
- مدل و نسخه کوانتیزهشده را دقیق انتخاب کنید.
- طول Context و تعداد درخواست همزمان را مشخص کنید.
- مصرف VRAM را با مدل بارگذاریشده و هنگام اجرای درخواست ثبت کنید.
- اگر حافظه کافی نیست، کاهش دقت، کاهش Context یا اجرای ترکیبی را با آزمون کیفیت و سرعت مقایسه کنید.
جاگیری فایل مدل روی دیسک، اجرای آن را روی GPU ثابت نمیکند. بخشی از حافظه کارت ممکن است در اختیار نمایشگر یا برنامههای دیگر باشد. ظرفیت اسمی را با حافظه در دسترس هنگام آزمون یکسان نگیرید.
جدول عوامل تعیینکننده حافظه موردنیاز
| عامل | اثر بر انتخاب حافظه | اطلاعات لازم برای سفارش |
|---|---|---|
| وزنهای مدل | بخش پایه حافظه؛ وابسته به نمایش عددی | فایل یا نسخه دقیق، تعداد پارامتر و کوانتیزهسازی |
| Context و کش | مصرف اضافی هنگام اجرا | طول ورودی و خروجی و تنظیمات کش |
| همزمانی | افزایش بار حافظه و صف درخواست | تعداد درخواست فعال و معیار تأخیر |
| نوع کار | استنتاج، تصویر و آموزش مصرف یکسان ندارند | گردش کار، رزولوشن یا تنظیمات آموزش |
تفاوت RAM و VRAM در اجرای هوش مصنوعی
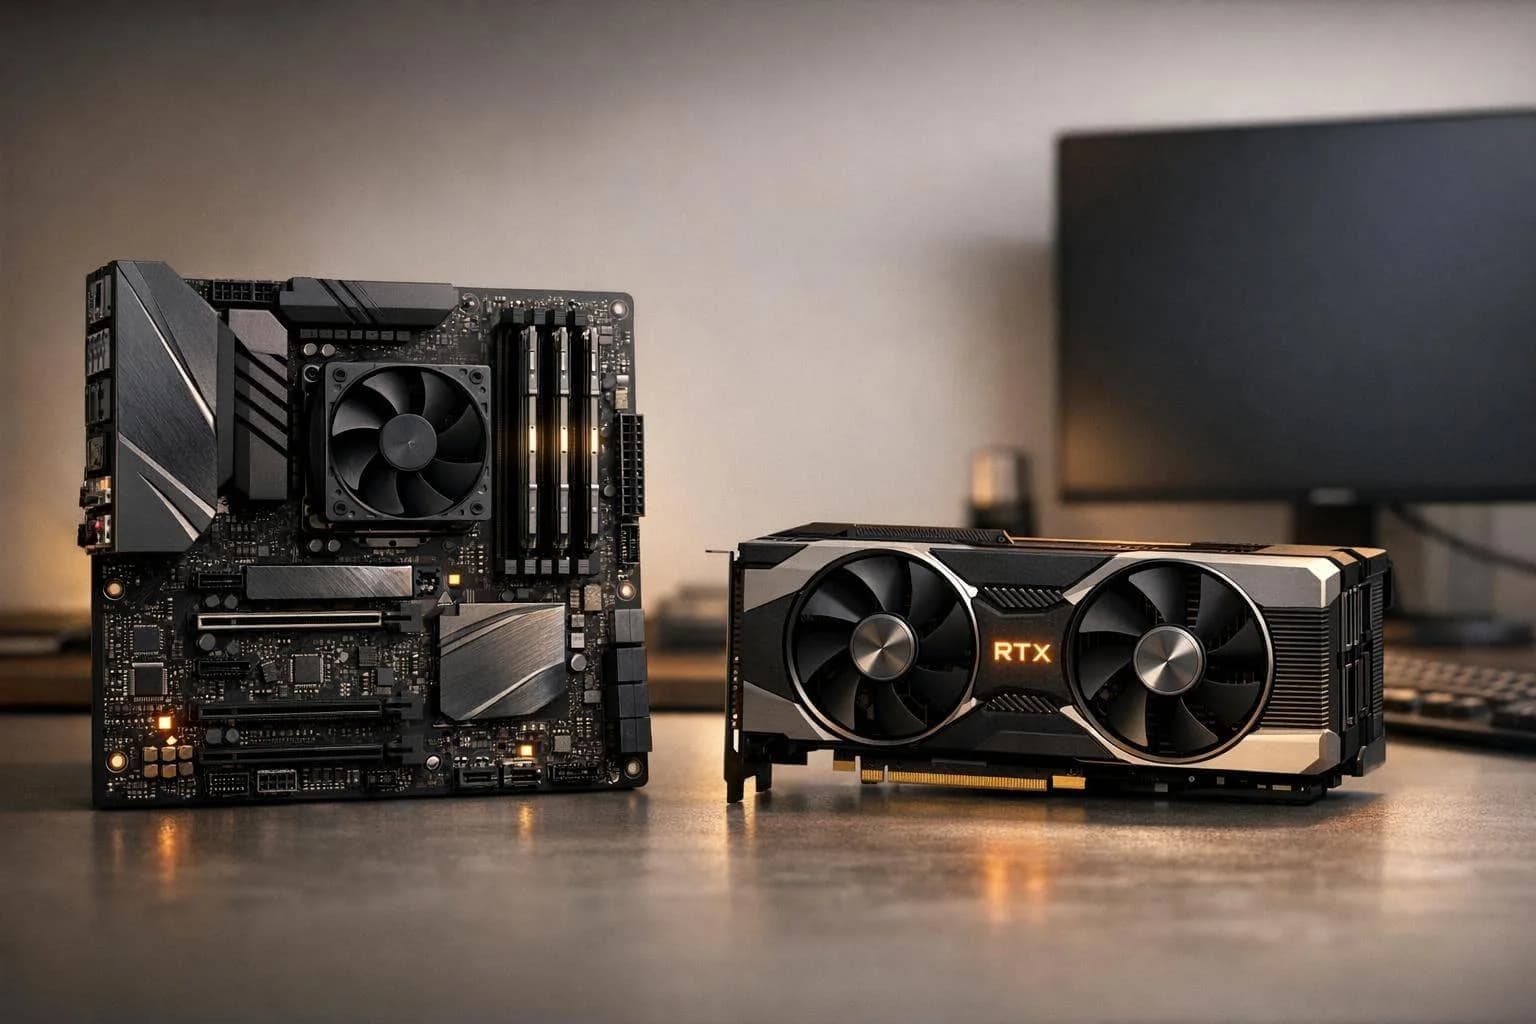
برای اجرای مدلهای هوش مصنوعی روی کامپیوتر شخصی، RAM و VRAM هر دو اهمیت دارند؛ اما ظرفیت بیشتر یکی، لزوما کمبود دیگری را جبران نمیکند. RAM حافظه اصلی سیستم است و VRAM حافظه اختصاصی کارت گرافیک محسوب میشود. تفاوت این دو مشخص میکند چه مدلی را میتوانید اجرا کنید و با چه سرعتی پاسخ بگیرید.
| معیار | RAM | VRAM |
|---|---|---|
| دسترسی اصلی | پردازنده و برنامههای سیستم | GPU دارای حافظه اختصاصی |
| مدل زبانی | اجرای CPU، بارگذاری یا بخش منتقلشده | وزنها و دادههای پردازشی تخصیصیافته به GPU |
| کمبود حافظه | فشار بر حافظه مجازی، کندی یا خطا | خطای حافظه یا نیاز به تغییر روش اجرا |
| انتخاب ظرفیت | بر اساس بار کاری و حافظه آزاد | بر اساس نسخه مدل و تنظیمات اجرای GPU |
نقش RAM در بارگذاری و اجرای مدل
RAM حافظهای است که پردازنده (CPU) برای دسترسی به دادهها و اجرای برنامهها از آن استفاده میکند. هنگام اجرای مدل زبانی بزرگ (LLM) با پردازنده، وزنهای مدل و دادههای موردنیاز پردازش در حافظه اصلی قرار میگیرند. بنابراین، ظرفیت RAM بر امکان اجرای مدلهای بزرگتر، استفاده همزمان از برنامهها و پردازش ورودیهای طولانی تأثیر میگذارد. برای مثال، سیستمی با 16 گیگابایت RAM ممکن است بتواند یک مدل زبانی کوانتیزهشده 7B را اجرا کند. اما برای مدلهای بزرگتر یا Context طولانی، حافظه بیشتری لازم است. بخشی از RAM نیز باید برای سیستمعامل و سایر برنامهها آزاد بماند. در نتیجه، ظرفیت اسمی RAM با حافظهای که واقعا به مدل اختصاص مییابد یکسان نیست.
تأثیر VRAM بر سرعت پردازش مدل با GPU
VRAM حافظه اختصاصی پردازنده گرافیکی (GPU) است و وزنهای مدل، دادههای میانی و حافظه موردنیاز محاسبات را در دسترس GPU قرار میدهد. هرچه بخش بیشتری از مدل در VRAM جا شود، امکان اجرای آن روی GPU بدون انتقال مداوم داده بین حافظهها بیشتر خواهد بود. این موضوع میتواند سرعت تولید پاسخ را بهبود دهد؛ البته قدرت پردازشی GPU، پهنای باند حافظه و بهینهسازی نرمافزار نیز مؤثرند.
برای نمونه، کارت گرافیکی با 8 گیگابایت VRAM میتواند برای اجرای بسیاری از مدلهای 7B یا 8B در نسخههای کوانتیزهشده مناسب باشد؛ اما اگر مدل، حافظه Context و فضای موردنیاز پردازش از ظرفیت آزاد کارت بیشتر شوند، ممکن است اجرای ترکیبی CPU و GPU لازم باشد. بنابراین، هنگام انتخاب کارت گرافیک برای اجرای محلی هوش مصنوعی، فقط به قدرت پردازنده گرافیکی توجه نکنید؛ ظرفیت VRAM هم اهمیت زیادی دارد.
آیا افزایش RAM کمبود VRAM را جبران میکند؟
افزایش RAM میتواند در برخی شرایط امکان اجرای مدلی را فراهم کند که تمام وزنهای آن در VRAM جا نمیشوند؛ اما لزوما سرعت اجرای آن را به سطح سیستمی با VRAM بیشتر نمیرساند. ابزارهایی مانند Ollama و کتابخانه Hugging Face Accelerate میتوانند بخشی از مدل را روی GPU و بخش دیگر را در حافظه سیستم اجرا کنند. در این روش که CPU offloading یا اجرای ترکیبی نامیده میشود، انتقال داده میان RAM و VRAM ممکن است سرعت پردازش را کاهش دهد.
برای مثال، کامپیوتری با 32 گیگابایت RAM و 8 گیگابایت VRAM ممکن است بتواند مدلی را اجرا کند که تمام وزنهایش در حافظه گرافیکی جا نمیشوند؛ به شرط آنکه مجموع حافظه در دسترس و نیازهای اجرایی کافی باشد و نرمافزار از این روش پشتیبانی کند. بااینحال، اجرای کامل مدل روی GPU معمولا از نظر کاهش انتقال داده مزیت دارد.
تخمین حافظه موردنیاز برای اجرای مدلهای هوش مصنوعی
برای تخمین حافظه موردنیاز اجرای یک مدل هوش مصنوعی، باید حجم وزنهای مدل را در کنار حافظه موردنیاز Context، پردازش و سایر برنامهها در نظر بگیرید. تعداد پارامترها و نوع کوانتیزهسازی، نقطه شروع مناسبی برای محاسبه هستند؛ اما حجم فایل مدل بهتنهایی مشخص نمیکند که مدل روی کامپیوتر شما اجرا خواهد شد یا نه.
چگونه حافظه موردنیاز یک مدل را تخمین بزنیم؟
یکی از سادهترین روشها برای تخمین حافظه موردنیاز مدل زبانی، محاسبه حجم وزنهای آن بر اساس تعداد پارامترها و دقت عددی است. برای این محاسبه، ابتدا تعداد پارامترهای مدل را مشخص کنید و سپس آن را در حافظه موردنیاز هر پارامتر ضرب کنید. برای تخمین اولیه، میتوان از رابطه زیر استفاده کرد:
برای مثال، مدل 7 میلیارد پارامتری (7B) در حالت FP16، بهطور نظری برای ذخیره وزنهای خود به حدود 14 گیگابایت حافظه نیاز دارد. اگر وزنها با کوانتیزهسازی 4 بیتی ذخیره شوند، این مقدار به حدود 3.5 گیگابایت کاهش مییابد. البته این محاسبه فقط حجم تقریبی وزنها را نشان میدهد، نه کل حافظه لازم برای اجرای مدل.
تفاوت Q4، Q8 و FP16 در مصرف حافظه
Q4، Q8 و FP16 روشهایی برای نمایش وزنهای مدل با دقتهای عددی متفاوت هستند. Q4 معمولا به نمایش 4 بیتی، Q8 به نمایش 8 بیتی و FP16 به اعداد ممیز شناور 16 بیتی اشاره دارد. کاهش تعداد بیتها معمولا حافظه موردنیاز وزنها را کم میکند، اما ممکن است بر دقت پاسخها و سرعت اجرا نیز تأثیر بگذارد.
| نوع نمایش وزنها | حافظه نظری هر پارامتر | حجم نظری وزنهای مدل 7B |
|---|---|---|
| Q4؛ کوانتیزهسازی ۴ بیتی | حدود ۰٫۵ بایت | حدود ۳٫۵ گیگابایت |
| Q8؛ کوانتیزهسازی ۸ بیتی | حدود ۱ بایت | حدود ۷ گیگابایت |
| FP16؛ دقت شناور ۱۶ بیتی | حدود ۲ بایت | حدود ۱۴ گیگابایت |
مقادیر جدول بر مبنای واحدهای دهدهی محاسبه شدهاند. حجم واقعی فایل ممکن است بهدلیل سربار کوانتیزهسازی، مقیاسها، ساختار مدل و قالب ذخیرهسازی متفاوت باشد.
کوانتیزهسازی چه مزیتی دارد؟ با استفاده از Q4 یا Q8 میتوان وزنهای مدل را با حافظه کمتری نگهداری کرد و اجرای مدلهای بزرگتر را روی سختافزار محدود امکانپذیر ساخت. در مقابل، FP16 دقت عددی بیشتری نسبت به نمایشهای 4 و 8 بیتی دارد، اما حافظه بیشتری مصرف میکند. البته Q4 همیشه سریعتر از Q8 یا FP16 نیست؛ سرعت نهایی به سختافزار، نرمافزار و پیادهسازی مدل بستگی دارد.
تأثیر طول Context و برنامههای همزمان بر مصرف RAM و VRAM
حافظه موردنیاز برای اجرای مدل هوش مصنوعی روی کامپیوتر فقط به وزنهای آن محدود نمیشود. هرچه طول Context بیشتر باشد، معمولاً حافظه بیشتری برای نگهداری اطلاعات توکنهای ورودی و خروجی مصرف میشود. در بسیاری از مدلهای زبانی، این حافظه با عنوان کش کلید و مقدار (KV Cache) شناخته میشود. برای مثال، اجرای یک مدل با Context برابر 4096 توکن ممکن است حافظه کمتری نسبت به همان مدل با Context برابر 32,768 توکن مصرف کند.
مقدار افزایش حافظه ثابت نیست و به معماری مدل، تعداد لایهها، تعداد سرهای توجه، نوع داده کش و تنظیمات اجرایی بستگی دارد. برنامههای همزمان نیز بر حافظه آزاد سیستم تأثیر میگذارند. مرورگر با تبهای متعدد، نرمافزارهای ویرایش تصویر، محیطهای برنامهنویسی یا اجرای همزمان چند مدل میتوانند بخشی از RAM و VRAM را اشغال کنند. در نتیجه، مدلی که در شرایط عادی اجرا میشود ممکن است هنگام افزایش Context یا اجرای برنامههای دیگر با خطای کمبود حافظه روبهرو شود. مستندات Ollama نیز توضیح میدهند که پردازش درخواستهای موازی به حافظه بیشتری نیاز دارد.
مدیریت کمبود VRAM در اجرای مدلهای هوش مصنوعی
هنگام اجرای هوش مصنوعی روی کامپیوتر، ظرفیت حافظه گرافیکی (VRAM) یکی از عوامل تعیینکننده در انتخاب مدل و سرعت پردازش است. اگر VRAM برای بارگذاری کامل مدل کافی نباشد، بسته به مدل و نرمافزار میتوان از روشهایی مانند کوانتیزهسازی، کاهش طول Context یا اجرای ترکیبی پردازنده و کارت گرافیک استفاده کرد. البته هر روش محدودیتهای خاص خود را دارد و ممکن است بر زمان پاسخگویی تأثیر بگذارد. در ادامه، میبینیم چطور میتوان با منابع محدود کنار آمد؛ بدون اینکه انتظار داشته باشیم هر مدلی روی هر سیستمی با سرعت بالا اجرا شود!
اجرای ترکیبی GPU و CPU چگونه کار میکند؟
در اجرای ترکیبی، بخشی از وزنهای مدل روی حافظه گرافیکی (VRAM) قرار میگیرد و بخش دیگر از طریق حافظه اصلی سیستم (RAM) و پردازنده (CPU) پردازش میشود. این روش که با اصطلاح CPU offloading نیز شناخته میشود، امکان اجرای بعضی مدلهایی را فراهم میکند که تمام وزنهایشان در VRAM جا نمیشوند. ابزارهایی مانند Hugging Face Accelerate از تخصیص لایههای مدل میان GPU و CPU پشتیبانی میکنند.
برای مثال، اگر مدل به VRAM بیشتری از ظرفیت آزاد کارت گرافیک نیاز داشته باشد، نرمافزار میتواند بخشی از لایههای آن را روی GPU و بخش دیگری را روی CPU اجرا کند. البته این قابلیت به ابزار و معماری مدل بستگی دارد. در این حالت، RAM باید برای نگهداری بخشهای منتقلشده و دادههای پردازشی کافی باشد. مزیت اصلی این روش، کاهش محدودیت ظرفیت VRAM است؛ اما قابل اجرا بودن یک مدل به معنای اجرای سریع آن نیست.
انتقال وزنها بین حافظه سیستم و GPU سربار ایجاد میکند و ممکن است زمان تولید هر پاسخ را افزایش دهد. بنابراین، اگر سرعت اهمیت زیادی دارد، اجرای کامل مدل روی GPU در صورت امکان معمولا انتخاب مناسبتری است.
عوامل مؤثر بر افت سرعت و زمان پاسخگویی
سرعت اجرای مدل زبانی فقط به قدرت کارت گرافیک وابسته نیست. هنگام اجرای هوش مصنوعی روی کامپیوتر، کمبود VRAM یا فشار بر سایر منابع سیستم میتواند زمان بارگذاری مدل و تولید پاسخ را افزایش دهد.
- میزان انتقال پردازش به CPU: هرچه بخش بیشتری از مدل خارج از GPU اجرا شود، احتمال افزایش زمان پاسخ بیشتر است؛ بهویژه اگر انتقال داده بین RAM و VRAM به گلوگاه تبدیل شود.
- ظرفیت RAM و VRAM آزاد: اشغال حافظه توسط مدلهای دیگر و برنامههای همزمان میتواند بارگذاری مدل را مختل کند یا باعث افت عملکرد شود.
- طول Context: ورودیهای طولانیتر معمولا حافظه بیشتری برای کش توجه (KV Cache) مصرف میکنند و ممکن است سرعت پردازش را کاهش دهند.
- قدرت پردازنده و پهنای باند حافظه: در اجرای ترکیبی، توان CPU و سرعت جابهجایی دادهها بین حافظه سیستم و GPU اهمیت بیشتری پیدا میکند.
- تعداد درخواستهای همزمان: پردازش چند درخواست یا اجرای چند مدل بهصورت موازی، حافظه بیشتری مصرف میکند و در صورت محدودیت منابع ممکن است باعث صف انتظار شود.
انتخاب لپتاپ یا کامپیوتر مناسب برای اجرای محلی هوش مصنوعی
انتخاب سیستم مناسب برای اجرای محلی مدلهای هوش مصنوعی به نوع مدل، حجم پردازش و انتظارتان از سرعت اجرا بستگی دارد. برای مدلهای زبانی کوچک، سیستم مجهز به RAM کافی و پردازنده مناسب ممکن است پاسخگو باشد. اما برای اجرای سریعتر مدلهای بزرگتر، تولید تصویر با هوش مصنوعی یا پردازشهای سنگین، کارت گرافیک و ظرفیت VRAM اهمیت بیشتری پیدا میکنند. پیش از خرید، بهتر است مدلها و نرمافزارهایی را که قصد استفاده از آنها دارید مشخص کنید. چون یک سیستم مناسب برای چت با مدل زبانی، لزوما بهترین گزینه برای تولید تصویر یا آموزش مدل نیست.
چه زمانی RAM بیشتر اولویت دارد و چه زمانی VRAM؟
برای انتخاب سختافزار مناسب اجرای هوش مصنوعی روی کامپیوتر، ابتدا مشخص کنید محدودیت اصلی سیستم، ظرفیت حافظه اصلی است یا حافظه گرافیکی.
- RAM بیشتر را زمانی بررسی کنید که مصرف حافظه اصلی یا اجرای CPU و ترکیبی گلوگاه است.
- VRAM بیشتر را زمانی بررسی کنید که مدل یا دادههای اجرایی در حافظه GPU جا نمیشوند.
- اگر مدل جا میشود اما کند است، قبل از خرید حافظه بیشتر، پردازش، پهنای باند و نرمافزار را بررسی کنید.
هنگام انتخاب لپتاپ یا کامپیوتر برای اجرای مدلهای هوش مصنوعی به چه مشخصاتی توجه کنیم؟
هنگام خرید، فقط به نام پردازنده یا مدل کارت گرافیک اکتفا نکنید. برای اجرای هوش مصنوعی روی کامپیوتر یا لپتاپ، این مشخصات را بررسی کنید:
| مشخصه | معیار بررسی |
|---|---|
| RAM | مصرف واقعی، نوع سازگار، تعداد ماژول و مسیر ارتقا |
| GPU و VRAM | پشتیبانی ابزار، ظرفیت آزاد و تنظیمات مدل |
| CPU | آمادهسازی داده و عملکرد بخشهای CPU محور |
| SSD | فایل مدل، داده فعال، محیط نرمافزار و خروجیها |
| پاور و خنککاری | سازگاری قطعات و پایداری در اجرای طولانی |
اگر جابهجایی لازم است، محدودیت حافظه و خنککاری لپتاپ را در آزمون در نظر بگیرید. برای دستگاه رومیزی، مسیر ارتقای قطعات را با مدل دقیق مادربرد و شاسی تأیید کنید. تصمیم نهایی باید با نسخه مدل، تنظیمات و سرعت موردنیاز هماهنگ باشد؛ عدد ظرفیت بهتنهایی نتیجه را تعیین نمیکند.
حداقل RAM برای اجرای هوش مصنوعی روی کامپیوتر چقدر است؟
حداقل ثابتی برای همه مدلها وجود ندارد. نسخه مدل، دقت وزنها، روش اجرای CPU یا GPU، طول ورودی و برنامههای همزمان را مشخص کنید؛ سپس حافظه آزاد و مصرف واقعی همان اجرا را بسنجید.
برای اجرای مدلهای هوش مصنوعی به چند گیگابایت VRAM نیاز داریم؟
ظرفیت لازم به نسخه مدل، دقت وزنها، Context، تعداد درخواست همزمان و سربار موتور اجرا وابسته است. حجم فایل مدل بهتنهایی کل VRAM موردنیاز را نشان نمیدهد.
برای اجرای هوش مصنوعی RAM مهمتر است یا VRAM؟
به روش اجرا بستگی دارد. اجرای مدل با CPU به RAM بیشتری متکی است؛ اما برای اجرای سریعتر مدل روی GPU، ظرفیت VRAM اهمیت زیادی دارد.
برای اجرای هوش مصنوعی روی لپتاپ چه مشخصاتی مناسب است؟
مدل و نرمافزار هدف، حافظه قابل استفاده، VRAM، توان و خنککاری لپتاپ را بررسی کنید. کانفیگ را با اجرای نمونه واقعی انتخاب کنید؛ یک مقدار عمومی RAM اجرای همه مدلها را تضمین نمیکند.
روش کاهش دقت را در راهنمای رسمی کوانتیزهسازی Transformers بررسی کنید. اثر طول ورودی بر حافظه نیز در مستندات Context در Ollama آمده است. اعداد حاصل از تعداد پارامتر × بیت، فقط برآورد نظری وزنها هستند؛ فراداده، کش و فضای اجرا به آن اضافه میشوند. GB دهدهی و GiB دودویی را در مقایسه یکسان فرض نکنید.
پس از تعیین نیاز حافظه، خرید کیس هوش مصنوعی و خرید سرور هوش مصنوعی را بر اساس کانفیگ کامل مقایسه کنید. برای انتخاب نرمافزار نیز راهنمای هوش مصنوعی لوکال را ببینید.


