برای خرید سیستم هوش مصنوعی، ابتدا مشخص کنید پردازش روی سرور آنلاین انجام میشود یا روی دستگاه خودتان. در اجرای محلی، سازگاری نرمافزار و ظرفیت حافظه، انتخاب GPU و نوع سیستم را تعیین میکنند. اگر فقط از ابزارهای آنلاین استفاده میکنید، خرید کارت گرافیک گران معمولاً اولویت ندارد؛ برای آموزش مدل هم باید نیاز حافظه را جدا از اجرای مدل آماده محاسبه کنید.
در ادامه، سختافزارهای ۲۰۲۵ و ۲۰۲۶، نیاز حافظه و تفاوت کیس و لپتاپ را مرور میکنیم. مشخصات این نسخه در ۱۲ اکتبر ۲۰۲۶، برابر با ۲۰ مهر ۱۴۰۵، بررسی شدهاند؛ کانفیگ و موجودی قابل خرید را در صفحه محصول ببینید.
برای انتخاب دستگاه فیزیکی، خرید کیس هوش مصنوعی و مقایسه کانفیگهای تاور یا خرید سرور هوش مصنوعی و مدلهای رکمونت را بررسی کنید. مدل هدف، نرمافزار، VRAM و تعداد کاربران را پیش از انتخاب کانفیگ مشخص کنید.
جدول انتخاب سریع برای خرید سیستم هوش مصنوعی
ظرفیتهای جدول، پیشنهاد اولیه برای انتخاباند. نیاز نهایی را با نسخه مدل، دقت وزنها، طول ورودی و تعداد کاربران تعیین کنید.
| کاربرد | RAM پیشنهادی برای شروع | گرافیک و حافظه | اولویت خرید |
|---|---|---|---|
| ابزارهای آنلاین و کار عمومی | ۱۶ تا ۳۲ گیگابایت | گرافیک مجتمع میتواند کافی باشد | SSD، اینترنت و تجربه کاربری |
| یادگیری برنامهنویسی و ML | ۳۲ گیگابایت | GPU سازگار؛ منابع ابری برای تمرینهای بزرگ | سازگاری محیط و امکان ارتقا |
| مدلهای زبانی کوچک و کوانتایزشده | ۳۲ گیگابایت | ۱۲ تا ۱۶ گیگابایت VRAM یا حافظه یکپارچه کافی پس از تست | مصرف حافظه و سرعت مدل منتخب |
| تولید تصویر و توسعه محلی جدیتر | ۳۲ تا ۶۴ گیگابایت | ۱۶ تا ۲۴ گیگابایت VRAM بهعنوان محدوده قابلبررسی | مدل، رزولوشن و ابزارهای موردنیاز |
| مدل بزرگتر، فاینتیون یا چند کار همزمان | ۶۴ گیگابایت و بیشتر، متناسب با پروژه | ۲۴ یا ۳۲ گیگابایت VRAM، حافظه یکپارچه بزرگتر یا GPU حرفهای/ابری | اندازهگیری پروژه و هزینه کل |
سیستم هوش مصنوعی چیست و چه سختافزاری لازم دارد؟
سیستم هوش مصنوعی کامپیوتری است که سختافزار و نرمافزار آن برای اجرای بار مشخصی از هوش مصنوعی مناسب باشد. این عنوان یک پیکربندی ثابت ندارد: دستگاهی که برای تبدیل گفتار به متن کافی است، ممکن است برای تولید ویدئو یا آموزش یک مدل بزرگ مناسب نباشد. برچسب AI روی جعبه، بهتنهایی ظرفیت اجرای پروژه شما را مشخص نمیکند.
CPU، GPU و NPU؛ هرکدام چه کاری انجام میدهند؟
| قطعه | نقش در سیستم | معیار خرید |
|---|---|---|
| CPU؛ پردازنده مرکزی | اجرای برنامه، آمادهسازی داده و بخشی از محاسبات مدل | سرعت مناسب، هسته کافی و هماهنگی با بار کاری |
| GPU؛ پردازنده گرافیکی | محاسبات موازی برای استنتاج، تولید تصویر و آموزش | حافظه، توان محاسباتی و پشتیبانی نرمافزار |
| NPU؛ پردازنده عصبی | اجرای کممصرف مدلها و قابلیتهای سازگار روی دستگاه | پشتیبانی برنامه و مدل، توان NPU و مصرف انرژی |
| RAM؛ حافظه سیستم | دادهها، برنامهها و قسمتهایی از مدل | ظرفیت، پهنای باند و قابلیت ارتقا |
| SSD | نگهداری و بارگذاری مدل و مجموعهداده | فضا، سرعت پایدار و امکان افزودن حافظه |
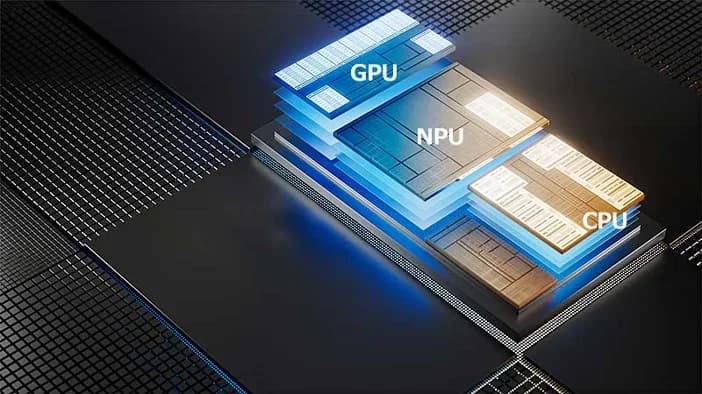
NPU برای کارهای سازگار و مصرف انرژی پایین طراحی شده است، اما جایگزین خودکار کارت گرافیک در همه پروژهها نیست. اجرای محلی یک مدل ممکن است روی GPU، CPU یا ترکیبی از آنها انجام شود و اصلاً از NPU استفاده نکند. به همین دلیل، نام نرمافزار و مسیر شتابدهی آن باید پیش از خرید مشخص باشد.
اول کاربرد را تعیین کنید؛ خرید برای سه سناریوی متفاوت
۱. استفاده از هوش مصنوعی آنلاین
اگر کار شما در مرورگر یا از طریق API انجام میشود، پردازش اصلی معمولاً روی سرور سرویس قرار دارد. خرید GPU گران فقط برای این کاربرد توجیه روشنی ندارد. رم کافی برای چندوظیفگی، SSD، نمایشگر خوب و اینترنت پایدار اولویت دارند. ۱۶ گیگابایت رم برای استفاده سبک نقطه شروع مناسبی است؛ ۳۲ گیگابایت برای کار همزمان با تبهای زیاد، ابزارهای توسعه و فایلهای سنگین حاشیه بیشتری میدهد.
۲. اجرای مدل روی کامپیوتر خودتان؛ استنتاج محلی
استنتاج یا Inference یعنی استفاده از مدل آماده برای تولید پاسخ، تصویر، صدا یا تحلیل داده. در این سناریو، مدل باید در حافظه قابلاستفاده جا بگیرد و با موتور اجرا سازگار باشد. اجرای محلی میتواند وابستگی به اینترنت را کمتر کند، اما باید بررسی کنید خود برنامه، افزونهها یا قابلیتهای جانبی دادهای به سرویس بیرونی ارسال میکنند یا نه.
برای شروع آزمون مدلهای زبانی روی دستگاه، میتوانید Ollama یا LM Studio را بررسی کنید. پیش از دریافت مدل، سازگاری سیستم و نیاز حافظه همان مدل را بخوانید. در Ollama اجرای محلی و استفاده از مدلهای ابری دو مسیر متفاوتاند؛ برای سنجش قدرت کامپیوتر، آزمون باید واقعاً بهصورت محلی انجام شود.
۳. یادگیری ماشین، فاینتیون و آموزش مدل
آموزش مدل به حافظه بیشتری از اجرای همان مدل نیاز دارد؛ زیرا علاوه بر وزنها، فعالسازیها، گرادیانها و وضعیت بهینهساز هم نگهداری میشوند. روشهای کمپارامتر مانند LoRA و QLoRA نیاز را کاهش میدهند، ولی امکان اجرای پروژه همچنان به مدل، طول ورودی، اندازه دسته و روش آموزش بستگی دارد. برای شروع یادگیری، ترکیب کامپیوتر متعادل و GPU ابری اغلب انتخاب عملیتری از خرید فوری یک ورکاستیشن بسیار گران است.
سختافزارهای جدید هوش مصنوعی در ۲۰۲۵ و ۲۰۲۶
در جدول زیر چند خانواده مهم معرفی شدهاند. مقایسه سرعت آنها به اجرای مدل و نرمافزار یکسان نیاز دارد.
| خانواده یا مدل | مشخصه تأییدشده | نکته کاربردی |
|---|---|---|
| GeForce RTX 5090 دسکتاپ | ۳۲ گیگابایت GDDR7؛ معماری Blackwell | GPU مستقل برای پروژههای سازگار؛ نیازمند بررسی برق و خنککاری |
| GeForce RTX 5080 دسکتاپ | ۱۶ گیگابایت GDDR7 | قدرت بالا با سقف حافظه کمتر از 5090 |
| AMD Ryzen AI 400 | تا ۶۰ TOPS روی NPU در بالاترین مدل معرفیشده | AI PC؛ مدلهای خانواده NPU یکسان ندارند |
| AMD Ryzen AI Max+ 395 | پیکربندیهای تا ۱۲۸ گیگابایت حافظه یکپارچه؛ NPU تا ۵۰ TOPS | گزینهای برای اجرای مدل با حافظه زیاد؛ بررسی موتور اجرا ضروری است |
| Intel Core Ultra Series 3 | تا ۵۰ TOPS روی NPU در مدلهای بالارده | نسل جدید لپتاپ؛ انتخاب بر اساس مدل دقیق پردازنده |
| Snapdragon X2 Elite | NPU با توان اعلامشده ۸۰ TOPS | پلتفرم ARM؛ سازگاری برنامهها و درایورها را بررسی کنید |
| Apple M5 Pro و M5 Max | حافظه یکپارچه و شتابدهنده عصبی در هر هسته GPU | مناسب بررسی برای مسیرهای نرمافزاری Apple Silicon |
| NVIDIA RTX PRO 6000 Blackwell | ۹۶ گیگابایت GDDR7 | گروه حرفهای با ظرفیت حافظه بالا |
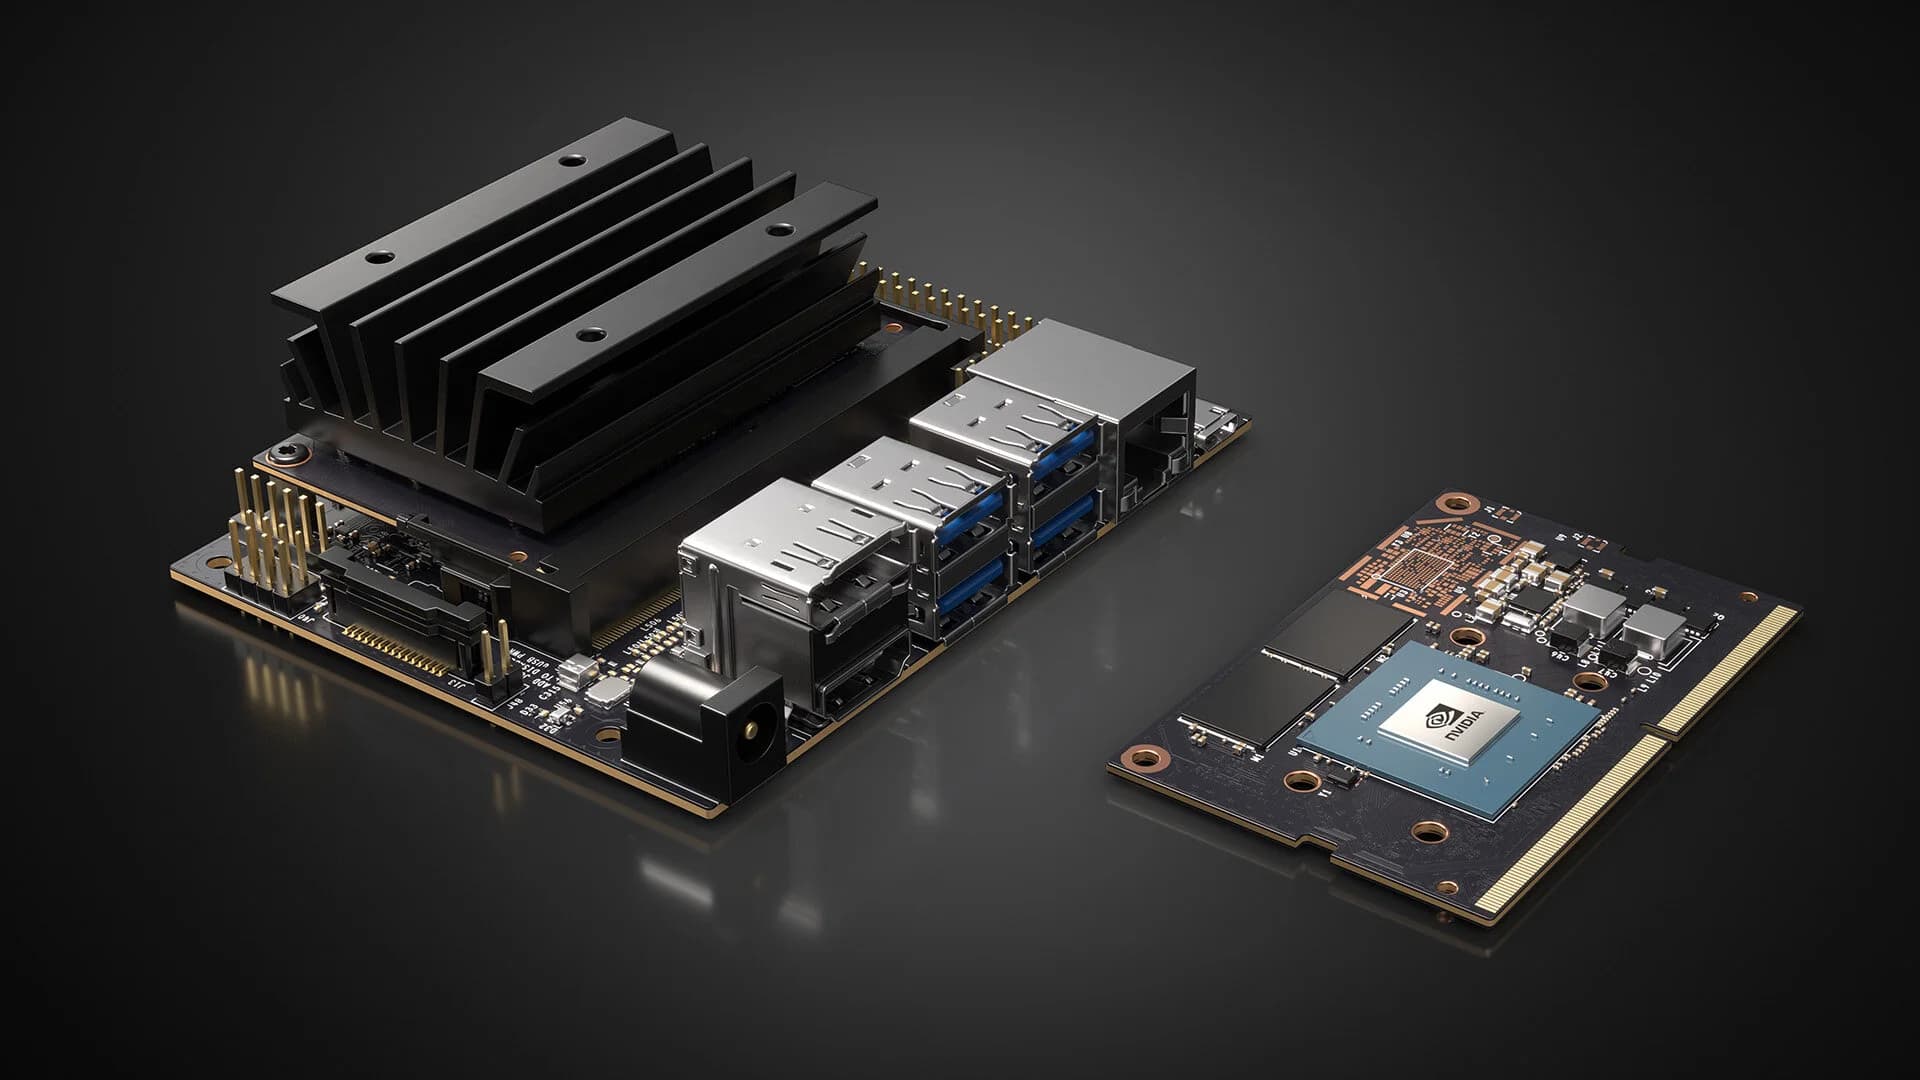
| NVIDIA DGX Spark | ۱۲۸ گیگابایت حافظه سیستم و تراشه Grace Blackwell | سیستم توسعه تخصصی؛ با کیس عمومی یکسان فرض نشود |
کارتهای گرافیک جدید؛ حافظه بیشتر همیشه مهم است؟
در نسل RTX 50، تفاوت ۱۶ و ۳۲ گیگابایت حافظه میتواند تعیین کند مدل با تنظیمات موردنظر کاملاً روی GPU اجرا شود یا بخشی از آن به RAM منتقل شود. با این حال، ظرفیت بیشتر بهتنهایی تضمین سرعت بالاتر نیست. پهنای باند حافظه، معماری GPU، پشتیبانی نوع داده و بهینهسازی موتور اجرا هم در نتیجه نقش دارند.
پردازندههای جدید AI PC؛ عدد NPU را چگونه بخوانیم؟
Ryzen AI 400، Core Ultra Series 3 و Snapdragon X2 نمونههایی از گسترش NPU در لپتاپها هستند. هنگام مقایسه، عدد مربوط به NPU را با مجموع توان CPU، GPU و NPU اشتباه نگیرید. همچنین بیشترین توان یک خانواده ممکن است فقط متعلق به یک مدل باشد؛ شماره دقیق پردازنده و مشخصات رسمی همان پیکربندی را بخوانید.
TOPS یعنی تریلیون عملیات در ثانیه و معمولاً یک سقف نظری است. دقت محاسبات، استفاده از تنکی یا Sparsity، شکل عملیات و روش اندازهگیری میتوانند متفاوت باشند. بنابراین دو عدد TOPS، بدون شرایط اندازهگیری همسان، رتبهبندی معتبر عملکرد واقعی نمیسازند. برای مدل زبانی، زمان رسیدن اولین پاسخ و توکن بر ثانیه معیارهای ملموستری هستند.
حافظه یکپارچه؛ مسیر متفاوت AMD و Apple
حافظه یکپارچه ۱۲۸ گیگابایتی را با VRAM اختصاصی ۱۲۸ گیگابایتی برابر ندانید. سیستمعامل و برنامهها نیز از همان ظرفیت استفاده میکنند و پهنای باند و توان GPU متفاوت است. در برخی پلتفرمها تخصیص حافظه گرافیکی تنظیمپذیر است، اما سقف قابلاستفاده به دستگاه و تنظیمات آن وابسته است.
سیستمهای حرفهای و شتابدهندههای دیتاسنتری
RTX PRO 6000 Blackwell و DGX Spark برای نیازهای تخصصیتری مطرح هستند. انتخاب آنها باید از محدودیت واقعی پروژه ناشی شود: ظرفیت حافظه، توسعه مدل، نرمافزار موردنیاز یا چند کاربر همزمان. جا گرفتن یک مدل بسیار بزرگ در حافظه به معنی پاسخگویی سریع یا مناسب بودن دستگاه برای هر نوع آموزش نیست.
برای مقایسه نمونههای سیستم تخصصی موجود در کاتالوگ استوکلند، کارتهای زیر را بررسی کنید. DGX Spark یک پلتفرم جمعوجور توسعه AI است؛ HP Z8 G5 یک سیستم تاور با گزینههای پیکربندی است. ظرفیت رم، GPU انتخابشده و سازگاری پروژه را در صفحه هر محصول جداگانه بسنجید.


شتابدهندههای دیتاسنتری، خوشههای GPU و سرویسهای ابری گروه دیگری هستند. در این مقیاس، شبکه بین شتابدهندهها، حافظه پرپهنایباند، ذخیرهسازی مشترک و مدیریت منابع اهمیت پیدا میکنند. مشخصات چنین زیرساختی را نباید به یک کیس خانگی تعمیم داد. برای آموزش گسترده، ارزیابی زیرساخت و هزینه استفاده، از انتخاب نام یک قطعه مهمتر است.
بردهای توسعه و هوش مصنوعی لبه؛ کاربردی متفاوت از کیس و لپتاپ
برخی پروژهها باید نزدیک دوربین، حسگر یا دستگاه صنعتی اجرا شوند. بردهای توسعه پردازش لبه برای چنین کاربردهایی مطرحاند و انتخاب آنها به درگاهها، محدودیت توان، نرمافزار و نیاز زمان پاسخ وابسته است. این گروه را هنگام خرید یک سیستم عمومی، همرده مستقیم لپتاپ یا ورکاستیشن فرض نکنید.
برای خرید سیستم هوش مصنوعی چقدر VRAM و RAM لازم است؟
VRAM حافظه اختصاصی GPU مستقل است؛ RAM حافظه اصلی سیستم است. اگر موتور اجرا اجازه دهد، میتوان بخشی از مدل را از GPU به RAM منتقل کرد؛ این روش Offload نام دارد و معمولاً هزینه سرعت دارد. افزایش RAM، محدودیت VRAM را در همه برنامهها رفع نمیکند و بعضی کارها بدون حافظه گرافیکی کافی با خطا متوقف میشوند.
برآورد ساده حافظه وزنهای مدل زبانی
برای برآورد اولیه، تعداد پارامترها را در تعداد بیت هر وزن ضرب کنید و بر ۸ تقسیم کنید. یک مدل متراکم ۸ میلیاردپارامتری در حالت ۴ بیت، فقط برای وزنهای خام حدود ۴ گیگابایت حافظه دهدهی میخواهد. در ۱۶ بیت همین وزنهای خام حدود ۱۶ گیگابایت میشوند. این محاسبه شامل حافظه موردنیاز اجرای کامل مدل نیست.
| اندازه مدل متراکم | وزن خام در ۴ بیت | وزن خام در ۱۶ بیت |
|---|---|---|
| ۸ میلیارد پارامتر | حدود ۴ گیگابایت | حدود ۱۶ گیگابایت |
| ۱۴ میلیارد پارامتر | حدود ۷ گیگابایت | حدود ۲۸ گیگابایت |
| ۳۲ میلیارد پارامتر | حدود ۱۶ گیگابایت | حدود ۶۴ گیگابایت |
| ۷۰ میلیارد پارامتر | حدود ۳۵ گیگابایت | حدود ۱۴۰ گیگابایت |
برای مدلهای Mixture of Experts یا MoE، تعداد پارامترهای فعال در هر توکن با کل وزنهای مدل یکسان نیست. برآورد فضای نگهداری را صرفاً از تعداد پارامترهای فعال انجام ندهید. حجم فایل مدل، راهنمای همان مدل و مصرف اندازهگیریشده در موتور اجرا مبنای مطمئنتری هستند.
سه مثال برای تبدیل نیاز مدل به تصمیم خرید
| نیاز نمونه | چه چیزی را بررسی کنید؟ | اثر روی خرید |
|---|---|---|
| یک مدل متراکم ۸B با وزن ۴بیتی برای چت تککاربره | وزن خام حدود ۴GB است؛ حجم فایل، کش KV و بافر اجرا هم فضا میخواهند. | از گزینههای سبک شروع کنید و قبل از خرید GPU گران، مدل واقعی را تست کنید. |
| همان مدل با اسناد طولانی یا چند درخواست همزمان | نیاز کش و ظرفیت همزمان افزایش مییابد؛ اندازه وزن ثابت میماند. | حافظه موردنیاز را از روی حجم فایل مدل بهتنهایی تعیین نکنید. |
| یک مدل متراکم ۳۲B با وزن ۴بیتی | وزن خام حدود ۱۶GB است؛ سربار کوانتایز و اجرای مدل به آن اضافه میشود. | کارت ۱۶GB را بدون تست، کافی فرض نکنید؛ VRAM بیشتر یا Offload را با سرعت واقعی بسنجید. |
طبق مستندات طول متن در Ollama، افزایش طول زمینه حافظه بیشتری میخواهد. هنگام مقایسه دو سیستم، این تنظیم را هم ثبت کنید.
برای تولید تصویر، صوت و ویدئو چه چیزی مهم است؟
در تولید تصویر، نیاز حافظه به مدل، رزولوشن، تعداد تصاویر همزمان و اجزای خط پردازش بستگی دارد. تولید ویدئو معمولاً با افزایش فریم و وضوح، فشار بیشتری بر حافظه وارد میکند. برای گفتار هم مدل، طول صوت و پردازش دستهای مهماند. یک عدد ثابت مانند «۸ گیگابایت برای همه کارهای AI کافی است» راهنمای خرید قابلاعتمادی نیست.
اگر مدل با کمبود حافظه روبهرو میشود، کاهش رزولوشن، اندازه دسته یا استفاده از روشهای کمحافظه ممکن است کمک کند، اما معمولاً محدودیت یا هزینه سرعت دارد. فروشنده باید توان اجرای کار را با مدل و تنظیمات مشخص نشان دهد؛ نمایش یک نمونه خروجی بدون مشخصات آزمون کافی نیست.
سازگاری نرمافزار؛ مهمترین بررسی پیش از پرداخت
- NVIDIA: نسخه درایور، CUDA، چارچوب و پشتیبانی معماری کارت باید هماهنگ باشند؛ مخصوصاً هنگام خرید نسل تازه.
- AMD: مدل دقیق GPU یا APU، سیستمعامل و نسخه ROCm را در جدول رسمی سازگاری بررسی کنید.
- Apple Silicon: پشتیبانی ابزار از macOS، Metal یا MLX را پیش از انتخاب ظرفیت حافظه تأیید کنید.
- Windows on ARM: نسخه ARM برنامهها، کتابخانهها و درایورهای دستگاه جانبی را بررسی کنید؛ شبیهسازی اجرای همه اجزای پروژه را تضمین نمیکند.
- NPU: اطمینان بگیرید برنامه و مدل واقعاً امکان استفاده از NPU همان دستگاه را دارند.
CPU، رم، SSD، مادربرد و پاور را چگونه انتخاب کنیم؟
پردازنده مرکزی و رم
CPU در آمادهسازی داده، فشردهسازی، اجرای ابزارهای توسعه و تغذیه GPU نقش دارد. برای پروژهای که عمدتاً محدود به GPU است، انتخاب گرانترین پردازنده لزوماً بهترین استفاده از بودجه نیست. برای پردازش سنگین داده، اجرای ماشین مجازی یا چند کار همزمان، هسته و رم بیشتر ارزش پیدا میکند. توازن قطعات را بر اساس گلوگاه واقعی بسنجید.
در یک سیستم توسعه محلی، ۳۲ گیگابایت رم نقطه شروع منعطفی است؛ برای دادههای بزرگ، Offload یا چند ابزار همزمان، ۶۴ گیگابایت و بیشتر قابلبررسی است. ظرفیت توصیهشده را به پروژه نسبت دهید، نه صرفاً به تعداد هسته. در لپتاپهای دارای رم لحیمشده، ظرفیت لازم را از ابتدا بخرید؛ در کیس، ظرفیت مادربرد و مسیر ارتقای رم را بررسی کنید.
SSD؛ ظرفیت را فقط با حجم یک مدل نسنجید
مدلها، نسخههای کوانتایزشده، دیتاستها، محیطهای نرمافزاری و خروجیها بهسرعت فضا مصرف میکنند. SSD یک ترابایتی برای شروع پروژههای محلی انتخاب قابلبررسی است؛ دو ترابایت برای چند مدل و داده بیشتر فضای راحتتری میدهد. سرعت بارگذاری، دوام، دمای SSD و عملکرد پایدار مهماند. سرعت تبلیغاتی لحظهای، معیار کافی برای کار طولانی نیست.
مادربرد، فضای کیس و مسیر ارتقا
طول و ضخامت GPU، جای اسلاتها، مسیر هوا و تعداد درگاههای ذخیرهسازی را قبل از خرید تطبیق دهید. اگر دو GPU در برنامه آینده شماست، فاصله اسلاتها، تعداد مسیرهای PCIe، پشتیبانی پردازنده و مادربرد و فضای خنککاری اهمیت دارند. دو کارت ۱۶ گیگابایتی را خودکار معادل یک کارت ۳۲ گیگابایتی فرض نکنید؛ تقسیم مدل به پشتیبانی نرمافزاری نیاز دارد.
پاور و خنککاری برای بار طولانی
پاور را بر اساس مدل دقیق GPU، توان کل سیستم، توصیه سازنده و کانکتور موردنیاز انتخاب کنید. یک عدد ثابت برای همه سیستمهای AI صحیح نیست. کیفیت پاور و اتصال صحیح کابلها به اندازه توان اسمی اهمیت دارند. کیس باید بتواند گرمای پردازش طولانی را دفع کند؛ تست کوتاه بدون بررسی افت سرعت، برای ارزیابی یک ورکاستیشن کافی نیست.
برای کارهایی که ساعتها ادامه دارند، دما، صدای فن، پایداری و مصرف برق را کنار سرعت بررسی کنید. اگر قطع برق محتمل است، UPS را بر اساس توان واقعی و زمان پشتیبانی موردنیاز انتخاب کنید. ذخیره نسخه پشتیبان از داده و تنظیم ذخیره دورهای آموزش نیز بخشی از آمادهسازی سیستم است.
کیس بهتر است یا لپتاپ هوش مصنوعی؟
| نوع سیستم | مزیت اصلی | محدودیت مهم | کاربرد مناسب |
|---|---|---|---|
| کیس دسکتاپ | ارتقا، تنوع GPU و خنککاری انعطافپذیر | نیاز به فضای ثابت و تجهیزات جانبی | پردازش محلی طولانی و توسعه قابلارتقا |
| لپتاپ | قابلیت حمل و سیستم کامل | سقف توان، حافظه و ارتقای محدود | کار سیار و پروژههای متناسب با ظرفیت دستگاه |
| مینیپیسی با حافظه یکپارچه | ابعاد کوچک و گزینههای حافظه بالا در برخی مدلها | ارتقای GPU و رم غالباً محدود | اجرای محلی پس از تأیید سازگاری و سرعت |
| لپتاپ یا کیس متعادل همراه GPU ابری | دسترسی مقطعی به منابع بزرگتر | هزینه جاری، اینترنت و انتقال داده | آموزش یا پروژه سنگین با استفاده غیرمداوم |
هنگام خرید لپتاپ برای هوش مصنوعی به این موارد دقت کنید
- مدل دقیق GPU و مقدار VRAM را بخوانید؛ نام سری لپتاپ کافی نیست.
- توان گرافیک یا TGP، حالت عملکرد و رفتار دستگاه پس از گرم شدن را بررسی کنید.
- مشخص کنید رم قابلارتقا است یا روی برد قرار دارد و چند درگاه SSD در دسترس است.
- وزن واقعی همراه شارژر، کیفیت نمایشگر، درگاهها و امکان اتصال مانیتور را بسنجید.
- عملکرد با برق و باتری را جداگانه ارزیابی کنید؛ نتیجه یک حالت به حالت دیگر تعمیمپذیر نیست.
- برای کار فارسی، مدل و برنامه فارسی موردنظر را تست کنید؛ NPU قوی کیفیت پاسخ فارسی را تعیین نمیکند.
کارتهای زیر دو مسیر متفاوت را برای مقایسه نشان میدهند: HP OMEN MAX 16 با GPU مستقل NVIDIA و HP ZBook Ultra G1a با حافظه یکپارچه و گرافیک AMD. در کانفیگهای فعلی کاتالوگ، OMEN دارای ۲۴ گیگابایت VRAM است؛ نسخههای ZBook رم مشترک ۶۴ یا ۱۲۸ گیگابایتی دارند. ظرفیت مشترک ZBook را با VRAM مستقل برابر نگیرید و مسیر CUDA یا AMD موردنیاز پروژه را قبل از انتخاب بررسی کنید.


سیستم محلی یا پردازش ابری؛ هزینه واقعی را مقایسه کنید
در محاسبه هزینه محلی، فقط مبلغ کیس یا لپتاپ را نبینید؛ برق، استهلاک، ارتقا، فضای نگهداری، زمان نصب و نگهداری و تجهیزات جانبی هم سهم دارند. در پردازش ابری، هزینه ساعت GPU، ذخیرهسازی، انتقال داده و منابعی که روشن باقی میمانند مهماند. اگر استفاده شما مقطعی است، قبل از خرید سنگین یک اجرای آزمایشی ابری انجام دهید.
برای استفاده مداوم و پروژهای که از ظرفیت دستگاه فراتر نمیرود، سیستم محلی میتواند کنترل و دسترسپذیری بیشتری بدهد. برای بارهای متغیر یا آموزش بسیار سنگین، منابع ابری انعطاف دارند. نقطه اقتصادی هر انتخاب را از ساعات استفاده واقعی و هزینه جاری همان زمان حساب کنید؛ قیمت جهانی یک قطعه را معادل قیمت نهایی بازار ایران فرض نکنید.
برای مقایسه قیمت، از هر فروشنده فهرست کامل قطعات را بگیرید: مدل GPU و VRAM، ظرفیت و قابلیت ارتقای رم، SSD، پاور و اقلام همراه. مبلغ نهایی کانفیگ را مقایسه کنید؛ ممکن است قیمت پایه بعضی قطعات را شامل نشود.
چکلیست خرید کیس یا لپتاپ هوش مصنوعی
- کاربرد را دقیق بنویسید: اجرای مدل زبانی، تصویر، صوت، ویدئو، فاینتیون یا ابزار آنلاین.
- نام و نسخه نرمافزار، مدل AI و نوع فایل یا کوانتایز را مشخص کنید.
- حافظه موردنیاز را با طول ورودی، اندازه دسته و تعداد کاربران بسنجید.
- مدل دقیق CPU، GPU، VRAM، RAM و SSD پیکربندی فروشنده را تأیید کنید.
- پشتیبانی سیستمعامل، درایور و موتور اجرا را از منابع رسمی بررسی کنید.
- برای کیس، پاور، کابلها، ابعاد GPU، مسیر هوا و اسلاتهای ارتقا را تطبیق دهید.
- برای لپتاپ، TGP، رم قابلارتقا، شارژر و عملکرد پایدار را بررسی کنید.
- آزمون مدل واقعی را با تنظیمات ثبتشده انجام دهید و سرعت، حافظه و دما را یادداشت کنید.
- هزینه کامل خرید و نگهداری را با استفاده ابری مقایسه کنید.
- شرایط تست، خدمات پس از خرید و سلامت قطعات را متناسب با نوع دستگاه بررسی کنید.
در خرید سیستم استوک چه بررسیهای بیشتری لازم است؟
در کیس یا لپتاپ استوک، مشخصات روی کاغذ بهتنهایی کافی نیست. سلامت GPU و حافظه آن، پایداری زیر بار، وضعیت فنها، نشانههای تعمیر و گزارش سلامت SSD را بررسی کنید. برای لپتاپ، سلامت باتری، شارژر مناسب و وضعیت درگاهها هم مهماند. ورکاستیشن قدیمی با CPU پرهسته ممکن است در مصرف برق یا پشتیبانی نرمافزار برای پروژه امروز انتخاب مناسبی نباشد.
تست را با تنظیمات کارخانهای انجام دهید و خطاهای حافظه، توقف برنامه یا افت غیرعادی سرعت را ثبت کنید. سابقه استفاده قطعه را از ظاهر آن حدس نزنید. اگر خرید برای یک کار تجاری مشخص است، امکان اجرای همان پروژه و شرایط رسیدگی به مشکل را پیش از پرداخت روشن کنید.
چگونه عملکرد سیستم را پیش از خرید آزمایش کنیم؟
یک آزمون قابلمقایسه باید مدل، کوانتایز، نسخه نرمافزار، طول ورودی، اندازه دسته و حالت توان یکسان داشته باشد. برای مدل زبانی، زمان بارگذاری، زمان اولین توکن و سرعت تولید ادامه متن را جداگانه ثبت کنید. برای تصویر، مدل، رزولوشن، تعداد گامها و زمان تولید هر تصویر را بنویسید. برای آموزش، مصرف حافظه و زمان هر گام با اندازه دسته مشخص را بسنجید.
آزمون را تا گرمشدن و رسیدن دستگاه به عملکرد پایدار ادامه دهید. در کنار سرعت، دما، خطا و مصرف GPU را ثبت کنید تا معلوم باشد پردازش روی کدام قطعه انجام شده است.
فرم آزمون پیشنهادی؛ این اطلاعات را از فروشنده بگیرید
| اطلاعات آزمون | چه چیزی ثبت شود؟ |
|---|---|
| مدل و محیط | نام کامل مدل، کوانتایز، نسخه نرمافزار، سیستمعامل و درایور |
| ورودی و خروجی | طول متن، تعداد درخواست همزمان؛ یا رزولوشن، گامها و افزونههای تصویر |
| اجرای محلی | مصرف RAM و VRAM و سهم پردازش روی CPU/GPU |
| سرعت | زمان اولین پاسخ و توکن بر ثانیه؛ یا زمان هر تصویر و زمان هر گام آموزش |
| پایداری | مدت آزمون، حالت توان، دمای GPU/CPU، افت سرعت و خطاهای مشاهدهشده |
ollama ps در زمان اجرای مدل، ستونهای PROCESSOR و CONTEXT را نشان میدهد. از آن برای ثبت تقسیم پردازش و طول متن تخصیصیافته استفاده کنید؛ این فرمان بهتنهایی بنچمارک سرعت نیست. برای مقایسه، خروجی هر دو دستگاه را با تنظیمات یکسان نگه دارید.پرسشهای متداول درباره خرید سیستم هوش مصنوعی
آیا برای استفاده از هوش مصنوعی حتماً کارت گرافیک قوی لازم است؟
برای ابزارهای آنلاین معمولاً خیر؛ پردازش اصلی روی سرور انجام میشود. برای اجرای محلی و آموزش، نیاز به GPU و حافظه آن به مدل و نرمافزار بستگی دارد. بعضی مدلهای کوچک روی CPU هم اجرا میشوند، اما سرعت باید متناسب با کار شما باشد.
آیا لپتاپ دارای NPU برای اجرای همه مدلهای AI کافی است؟
خیر. NPU فقط وقتی مفید است که نرمافزار و مدل از آن پشتیبانی کنند. اجرای مدلهای زبانی، تولید تصویر و آموزش ممکن است به GPU یا مسیر دیگری وابسته باشد. ظرفیت حافظه و عملکرد واقعی را جداگانه بررسی کنید.
برای هوش مصنوعی رم مهمتر است یا VRAM؟
هر دو نقش متفاوتی دارند. در اجرای کامل روی GPU مستقل، VRAM محدودیت مستقیم ایجاد میکند؛ RAM برای دادهها، برنامهها و Offload لازم است. در حافظه یکپارچه، CPU و GPU ظرفیت مشترک دارند، اما پهنای باند و ظرفیت قابلاستفاده همچنان اهمیت دارد.
آیا کارت گرافیک ۸ گیگابایتی برای AI مناسب است؟
برای بعضی مدلها و تنظیمات سبک میتواند مناسب باشد، ولی برای همه کارها کافی نیست. مدلهای بزرگتر، تولید تصویر با تنظیمات سنگین و ویدئو ممکن است به حافظه بیشتری نیاز داشته باشند. انتخاب را با تست کاربرد مشخص انجام دهید.
برای هوش مصنوعی NVIDIA بهتر است یا AMD یا Apple؟
پاسخ به نرمافزار شما وابسته است. پروژهای که CUDA میخواهد با NVIDIA مسیر مشخصتری دارد؛ AMD نیازمند بررسی پشتیبانی مدل دقیق و ROCm است؛ Apple Silicon برای ابزارهای سازگار با Metal و MLX قابلبررسی است. انتخاب برند بدون بررسی پروژه کافی نیست.
آیا دو GPU حافظهشان را خودکار با هم جمع میکنند؟
خیر. توزیع مدل یا پردازش روی چند GPU به موتور اجرا، روش تقسیم و ارتباط بین کارتها بستگی دارد. دو GPU با VRAM شانزده گیگابایتی در همه برنامهها رفتار یک GPU سیودو گیگابایتی را ندارند.
آیا لپتاپ هوش مصنوعی میتواند کاملاً آفلاین کار کند؟
اگر مدل و فایلهای لازم دریافت شده باشند و نرمافزار برای اجرای محلی طراحی شده باشد، اجرای برخی کارها آفلاین ممکن است. نیاز به فعالسازی، دریافت مدل، سرویسهای جانبی و اتصال افزونهها را جداگانه بررسی کنید.
آیا بالاترین TOPS به معنی بهترین سیستم هوش مصنوعی است؟
خیر. TOPS یک شاخص نظری است و به شرایط محاسبه وابسته است. معیار عملی، اجرای مدل شما با سرعت، کیفیت، مصرف حافظه و توان مناسب است؛ مقایسه اعداد با دقت یا روش اندازهگیری متفاوت میتواند گمراهکننده باشد.


